



Ви чули про парадокс Моравека? Парадокс зазначає, що вдосконалені міркування вимагає дуже мало обчислювальної сили для системи штучного інтелекту (AI), при цьому реалізуючи навички перцептивного руху, які люди приймають як належне, вимагають величезних обчислювальних ресурсів. По суті, складні логічні завдання простіші для AI, ніж основні сенсорні завдання, які можуть виконувати людські інстинкти. Цей парадокс підкреслює різницю між AI та когнітивними здібностями людини на цьому етапі.
Люди за своєю суттю мультимодальні. Кожен з нас схожий на розумний термінал, який зазвичай повинен ходити до школи, щоб бути освіченим (навченим), але мета та результат цього навчання та навчання полягає в тому КОНТРОЛЬ.
Ми дізнаємось про навколишній світ через кілька сенсорних модальностей, таких як зір, мовлення, звук, дотик, смак та запах для аналізу, розуму, вирішення та вживання заходів.
Після багатьох років синтезу датчиків та еволюції AI, роботи на цьому етапі значною мірою оснащені мультимодальними датчиками. Коли ми приносимо більше обчислювальної потужності до пристроїв, таких як роботів, ці пристрої стають розумнішими та розумнішими, здатними відчути своє оточення, розуміння та спілкування природною мовою, набуття хаптиків за допомогою цифрових інтерфейсів зондування, а також відчуття конкретної сили робота,, кутова швидкість і навіть магнітне поле навколо робота за допомогою комбінації акселерометрів, гіроскопів та магнітометрів тощо.
До нової ери робототехніки та машинного пізнання
До трансформаторів та великих мовних моделей (LLMS) реалізація мультимодальності в AI зазвичай вимагала використання декількох окремих моделей, відповідальних за різні типи даних (текст, зображення, аудіо) та інтеграція різних модальностей за допомогою складного процесу.
З появою моделей трансформаторів та LLMS, мультимодальність стала більш інтегрованою, що дозволяє одній моделі одночасно обробляти та розуміти декілька типів даних, що призводить до систем AI, які здатні всебічно відчути своє середовище. Цей зсув значно підвищив ефективність та ефективність мультимодальних програм AI.
У той час як LLM, такі як GPT -3, в першу чергу на основі тексту, галузь досягла швидкого прогресу до мультимодальності. З кліпу OpenAi та Dall-E, а тепер Сора та GPT -4 O є прикладами моделей, які рухалися до мультимодальності та більш природної взаємодії людини-комп'ютер. Наприклад, кліп розуміє зображення, поєднані з природною мовою, таким чином подорожуючи розрив між візуальною та текстовою інформацією; DALL-E має на меті генерувати зображення на основі текстових описів. Ми бачимо, що модель Google Gemini зазнає подібної еволюції.
У 2024 році багатомодальна еволюція прискорюється. У лютому OpenAi випустив Sora, яка генерує реалістичні або образні відео на основі текстових описів. Коли ви думаєте про це, це може забезпечити перспективний шлях до побудови універсальних світових тренажерів або стати важливим інструментом для навчання роботів. Через три місяці GPT -4 O значно покращив продуктивність взаємодії людини-робота і здатний в режимі реального часу між аудіо, зором та текстом. Поєднання текстової, візуальної та аудіоінформації для підготовки нової моделі в кінці усуває два модальні переходи від модальності введення до тексту, а потім від тексту до модальності виведення, що, в свою чергу, значно покращує продуктивність.
Того ж тижня в лютому Google випустив Gemini 1.5, який різко розширив тривалість контексту до 1 мільйона жетонів. Це означає, що 1,5 Pro може одразу обробляти велику кількість інформації, включаючи годину відео, 11 годин аудіо та базу коду, яка містить більше 30, 000 рядків коду або 700, 000}}} слова.gemini 1.5 побудований на провідних дослідженнях Google щодо трансформаторів та архітектури експертів змішаних членів (MOE) та моделях з відкритим кодом 2b та 7b, які можна розгорнути на краю. На конференції вводу/виводу Google у травні, крім подвоєння тривалості контексту та випуску низки генеративних інструментів та додатків AI, Google дослідив своє бачення майбутнього проекту Astra, асистента AI загального призначення, який обробляє мультимодальну інформацію , розуміє контекст, в якому розміщується користувач, і взаємодіє з людьми в розмовах дуже природно.
Як компанія, що стоїть за відкритим кодом LLM Llama, Meta також приєднується до загального треку штучного інтелекту (AGI).
Ця справжня мультимодальність значно підвищує рівень машинного інтелекту і призведе до нових парадигм для багатьох галузей.
Наприклад, роботи були дуже однорідними, з деякими датчиками та можливостями руху, але, як правило, у них не було "мозку", щоб вивчити нові речі та адаптуватися до неструктурованих та незнайомих умов.
Очікується, що мультимодальні LLMS перетворить здатність роботів аналізувати, обґрунтувати та вивчати, переміщувати їх від спеціалізації до узагальнення. ПК, сервери та смартфони-це лідери обчислювальних платформ загального призначення, і вони можуть запускати багато різних видів програмних додатків для досягнення найрізноманітніших функцій. Узагальнення допоможе збільшити масштаб, генерувати економію масштабу, а ціни можуть бути різко знижені, коли вони збільшуються, що призводить до доброчесного циклу прийняття в більшій кількості областей.
Елон Маск помітив переваги узагальненої технології на початку, оскільки роботи Tesla перетворилися з джмеля в 2022 році до Optimus Gen 1, оголошеного в березні 2023 року, і Gen 2, оголосив наприкінці 2023 року з постійно зростаючими можливостями та можливостями навчання. Протягом минулого 6-12 місяців ми були свідками ряду проривів у галузі робототехніки та гуманоїдної робототехніки.
Нові технології за робототехнікою нового покоління та втіленого інтелекту
Немає сумнівів, що у нас ще багато роботи, перш ніж втілений інтелект досягає масового виробництва. Нам потрібні більш легкі конструкції, триваліші часи та швидші, більш потужні обчислювальні платформи для обробки та інформації про дані датчика для прийняття своєчасних рішень та контрольних дій.
І ми рухаємось до створення гуманоїдних роботів; Тисячі років людської цивілізації створили всюдисущі середовища, розроблені для людини, і, як очікується, робототехнічні системи з гуманоїдами зможуть комфортно взаємодіяти з людьми та навколишнім середовищем та виконувати необхідні операції в середовищах, що існують людини, завдяки їх подібності у формі з людьми. Ці системи добре підходять для вирішення брудних, небезпечних та нудних завдань, таких як догляд за пацієнтами та реабілітація, роботи в галузі гостинності, навчальні посібники або супутники навчання в навчальній галузі та небезпечні завдання, такі як реакція на катастрофи та небезпечні поводження з матеріалами . Такі програми використовують ознаки гуманоїдної машини для людських атрибутів для полегшення природних взаємодій людини-робот, діяти в просторах, орієнтованих на людину, та виконувати завдання, які часто важко виконати традиційні роботи.
Багато компаній AI та робототехніки запускають нові дослідження та співпрацю щодо того, як тренувати роботів для кращого розуму та планування в нових неструктурованих умовах. Як новий "мозок" роботів, моделі, які попередньо навчаються на великій кількості даних, мають чудові можливості узагальнення, що дозволяють роботам бачити та зрозуміти їхнє середовище більш всебічно, регулювати свої рухи та дії на основі сенсорного зворотного зв'язку та оптимізувати їх продуктивність У різних динамічних умовах.
Як цікавий приклад, собака робота Бостона Dynamics, Spot, може виступати екскурсоводом у музеї, взаємодіючи з відвідувачами, представляючи їх на різні експонати та відповідаючи на їхні запитання. Це може бути важко повірити, але в цьому випадку розважальні, інтерактивні та тонкі виступи Spot важливіші, ніж переконатися, що факти є правильними.
Трансформатор робототехніки: Новий мозок робототехніки
Трансформатор робототехніки (RT) швидко розвивається для перекладу мультимодальних входів безпосередньо в код, що підходить. Google DeepMind's RT -2 виконує, а також його попередник, RT -1, з майже 100% успішністю при виконанні завдань, які були помічені раніше. Однак, коли навчається Palm-E (орієнтована на робот, втілену багатомодальну мову) та PALI-X (масштабна багатомовна модель зору та мови, не розроблена для роботів), RT -2 має кращі можливості узагальнення і перевершує RT -1 на небачених завдань.
Microsoft представила Llava, масштабну мову та помічник зору. Спочатку розроблений для текстових завдань, Llava використовує потужність GPT -4, щоб створити нову парадигму для мультимодальних інструкцій, щоб дотримуватися даних, безперешкодно інтегруючи текстові та візуальні компоненти, що може бути корисним для робототехнічних завдань. Після вступу Llava встановив нові записи для мультимодальних завдань для чату та наукових запитів, які вже перевищують середні можливості людини.
Як згадувалося раніше, набіг Tesla в гуманоїдну та AI загальну цільову робототехніку є значущим не лише тому Роботи. Tesla також має розумний випадок використання виробництва для застосування Optimus до свого нового процесу виробництва енергетичних транспортних засобів.
Рука - наріжний камінь майбутнього робототехніки
ARM вважає, що робототехнічний мозок, як "великий мозок", так і "маленький мозок", повинен бути неоднорідною обчислювальною системою AI, яка забезпечує найкращі показники, реакцію в режимі реального часу та енергоефективність.
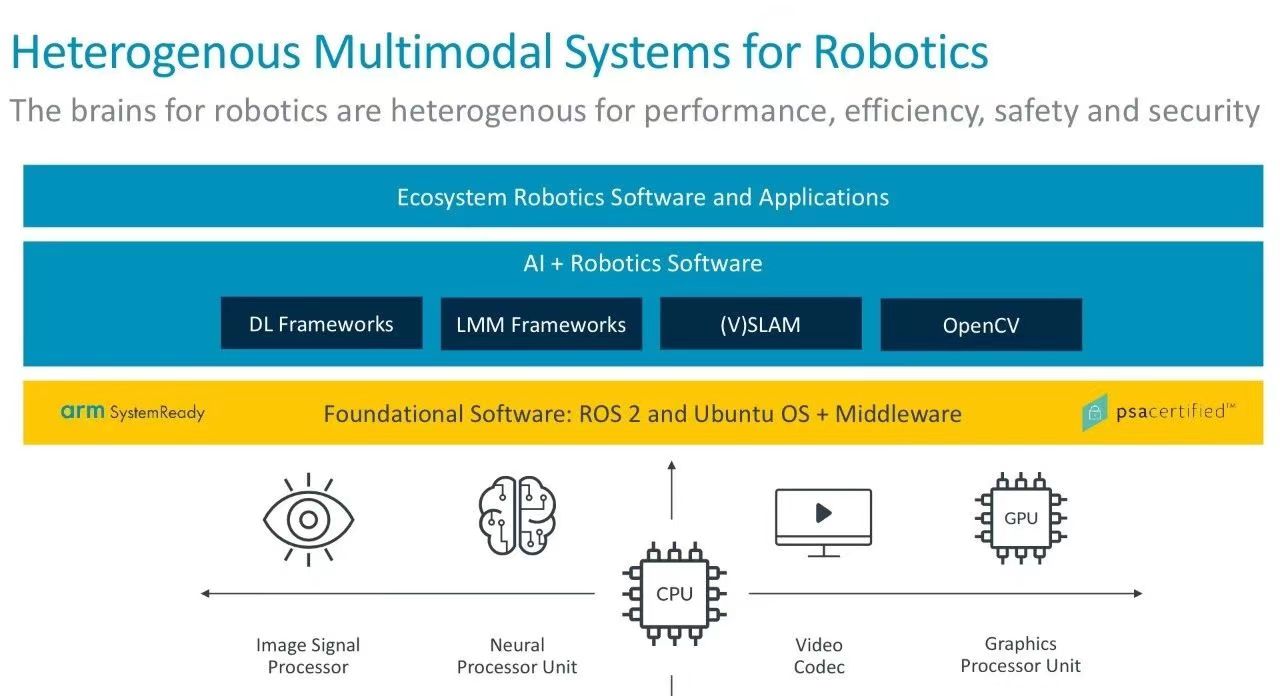
Робототехніка передбачає широкий спектр завдань, включаючи основні обчислення (наприклад, надсилання та отримання сигналів до двигунів та з нього), розширену обробку даних (наприклад, інтерпретація даних зображень та датчиків) та запуску багатомодальних LLMS, згаданих раніше. Процесор добре підходить для завдань загального призначення, тоді як педалі газу та графічні процесори AI можуть більш ефективно обробляти завдання паралельної обробки, такі як машинне навчання (ML) та графічна обробка. Додаткові педалі газу, такі як процесори сигналів зображень та відео -кодекси, також можуть бути інтегровані для підвищення можливостей зору роботи роботів та ефективності зберігання/передачі. Крім того, процесор повинен мати реагування в режимі реального часу і повинен мати можливість запускати операційні системи, такі як пакети Linux та ROS.
Якщо поширюватися на робототехнічний стек програмного забезпечення, шар операційної системи також може зажадати операційної системи в режимі реального часу (RTOS), яка може надійно обробляти критичні завдання, а також дистрибутив Linux, налаштований на робототехніку, наприклад ROS, яка може забезпечити Послуги, розроблені для неоднорідних обчислювальних кластерів. Ми вважаємо, що стандарти, спонсоровані ARM та програми сертифікації, такі як SystemReady та PSA, допоможуть масштабувати розробку робототехнічного програмного забезпечення. SystemReady розроблений для того, щоб стандартні розподіли на багатих ОС працювали на широкому діапазоні системних мікросхем (SOC) на основі архітектури ARM, тоді як сертифікований PSA допомагає спростити рішення щодо впровадження безпеки для задоволення регіональних вимог до безпеки та регуляторних вимог для підключених пристроїв.
Успіхи у масштабних мультимодальних моделях та генеративних AI Herald нова епоха в розвитку роботів AI та гуманоїдних роботів. Поряд з обчислювальними та екосистемами AI, енергоефективність, безпека та функціональна безпека є важливими для створення робототехніки в цій новій епоху. Процесори ARM вже широко використовуються в робототехніці, і ми з нетерпінням чекаємо тісної співпраці з екосистемою, щоб зробити ARM наріжним каменем майбутнього AI робототехніки.